IA aplicada · Verificação · Jurídico · Em produção
Petições jurídicas: extração verificada com LLMs
Agente que recebe a conversa completa do cliente de um escritório de advocacia, extrai os fatos do caso e os encaixa no padrão do escritório, com verificação independente do modelo antes de qualquer texto chegar ao advogado. Trabalho de 30–90 min pronto em ~2–3 min por caso.
Contexto
O cenário antes da solução
Advogados recebiam conversas longas com clientes (mensagens, áudios transcritos, prints de rastreadores de voo, procurações e comprovantes) e precisavam transformá-las em um resumo estruturado no padrão do escritório. Cada detalhe perdido, uma data, um valor ou um print não lido, virava retrabalho ou risco jurídico.
Extrair todos os detalhes relevantes da conversa, encaixá-los no modelo do escritório e garantir que nada produzido pelo modelo chegue ao advogado sem uma verificação que não dependa do próprio modelo, mantendo custo e latência por caso sob controle.
Meu papel
O que eu planejei, desenvolvi e implantei
Arquitetura do pipeline de extração e verificação, engenharia e otimização de prompts, definição das invariantes determinísticas, ciclo de tratamento dos erros reportados pelos advogados, telemetria de custo por etapa e a suíte de 520 testes.
Arquitetura
Como o sistema funciona
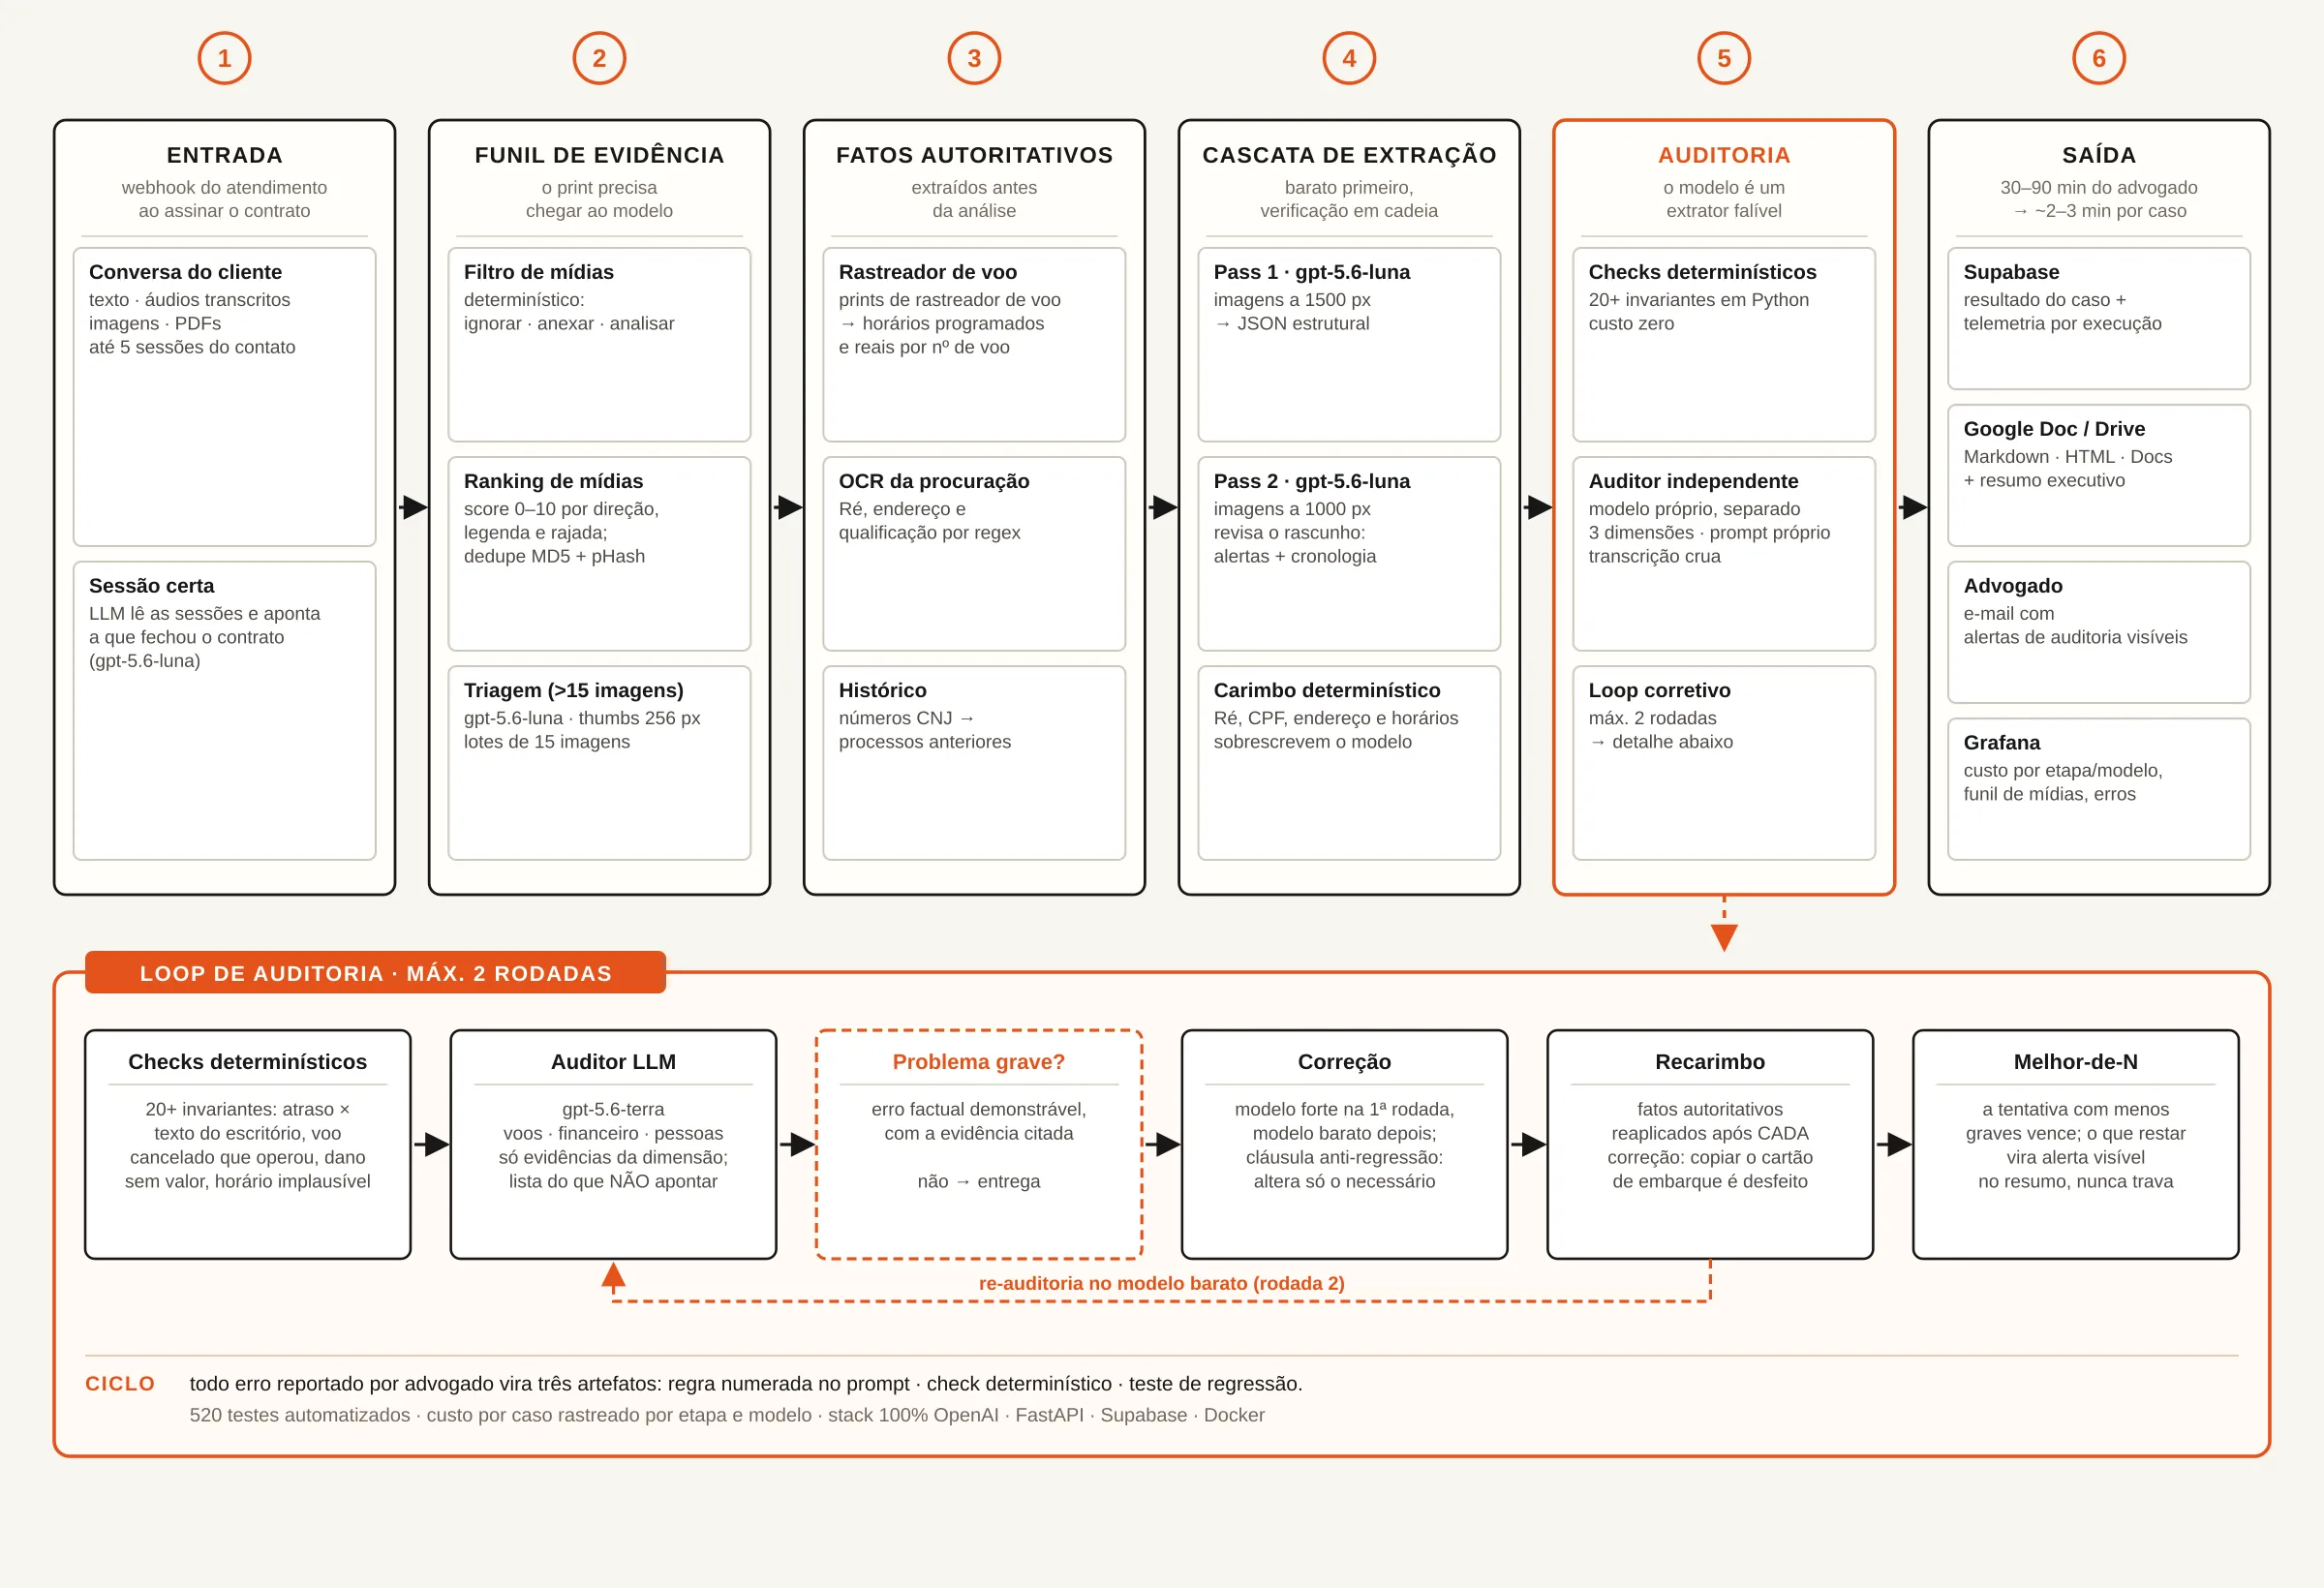
Princípio: o modelo é um extrator falível. Um webhook do sistema de atendimento dispara o caso; um funil determinístico filtra e ranqueia as mídias (dedupe por MD5 e pHash) e, acima de 15 imagens, uma triagem barata em lotes de 15 decide o que os passes caros chegam a ver. Fatos autoritativos (horários lidos dos prints de rastreador, Ré e endereço por OCR da procuração, histórico de processos por regex) são extraídos antes da análise e injetados com prioridade máxima. A extração roda em cascata: Pass 1 gera o JSON estrutural, Pass 2 revisa o rascunho (alertas e cronologia) e um carimbo determinístico sobrescreve o que o modelo não decide. Em seguida, mais de 20 invariantes em Python e um auditor com modelo próprio, dividido em três dimensões (voos, financeiro e pessoas), conferem o resultado; achado grave dispara correção, recarimbo e re-auditoria, com no máximo duas rodadas e a melhor tentativa vencendo. O resultado vai para o Supabase, vira Google Doc com resumo executivo, chega ao advogado por e-mail e alimenta um Grafana com custo por etapa e modelo.
Decisões
Escolhas e trade-offs
Seis estratégias vêm de artigos, cada uma com um desvio deliberado: cascata de modelos (FrugalGPT), em que o estágio barato filtra o que o caro vê em vez de responder; Chain-of-Verification entre os dois passes; Self-Refine com o crítico separado (o auditor não compartilha prompt, transcrição nem modelo com quem escreveu, para evitar o self-enhancement bias descrito por Zheng et al.); LLM como juiz com uma lista explícita do que não pode apontar; melhor-de-N com verificador determinístico em vez de treinado; e evaluator-optimizer com limite de rodadas. Outras seis técnicas nasceram de erros reportados por advogados: funil de evidência (o print precisa chegar ao modelo), fatos autoritativos pré-análise, carimbo determinístico reaplicado a cada correção, cláusula anti-regressão no prompt de correção, lotes de 15 na triagem e as invariantes determinísticas. O stack é 100% OpenAI: gpt-5.6-luna nas etapas de volume e um modelo mais forte só onde ele decide algo: a primeira rodada de auditoria e a correção que fecha esse achado.
Desafios
Problemas encontrados
Evidências em formatos heterogêneos que não chegavam ao modelo; regressões silenciosas quando uma correção de prompt desfazia outra; mistura de atendimentos diferentes do mesmo cliente; delimitar o que o juiz pode e não pode apontar; e manter o custo por caso sob controle sem reduzir a qualidade da extração.
Resultados
O que foi alcançado
Trabalho que levava de 30 a 90 minutos do advogado fica pronto em cerca de 2 a 3 minutos por caso. Nenhum texto gerado chega ao advogado sem passar por verificação independente do modelo; o que a auditoria não resolve vira alerta visível no resumo, nunca um travamento. Custo por caso rastreado por etapa e modelo no Grafana e 520 testes automatizados sustentam a evolução do sistema.
Aprendizados
Aprendizados e evolução
Otimizar prompt sem um verificador fora do modelo só move o erro de lugar. Todo erro reportado vira três artefatos: regra numerada, check determinístico e teste de regressão. Essa combinação de literatura, com desvios conscientes, e de regras nascidas de erros reais foi o que deu ao sistema um comportamento previsível.