RAG e recuperação · Dados · Automação · Em produção
OS interno: contexto operacional com RAG multifonte
Sistema interno que unifica o contexto de clientes disperso em calls, WhatsApp, GitHub, boards e bases operacionais para consulta por chat, busca semântica, dashboards e integrações com IA.
Contexto
O cenário antes da solução
O contexto de um mesmo cliente estava fragmentado entre bases operacionais, transcrições de calls, mensagens de WhatsApp, repositórios no GitHub e tarefas em boards. Pessoas e sistemas de IA não tinham uma visão única, atualizada e auditável.
Consolidar fontes heterogêneas, reconciliar a identidade de cada cliente e recuperar apenas o contexto relevante com isolamento de acesso, baixa latência e custo controlado de tokens.
Meu papel
O que eu planejei, desenvolvi e implantei
Desenvolvimento solo da modelagem de dados às interfaces de consumo: migrations, pipelines de ingestão, enriquecimento com LLM, embeddings, retrieval, API, chat, servidor MCP, frontend, autorização, avaliações e observabilidade.
Arquitetura
Como o sistema funciona
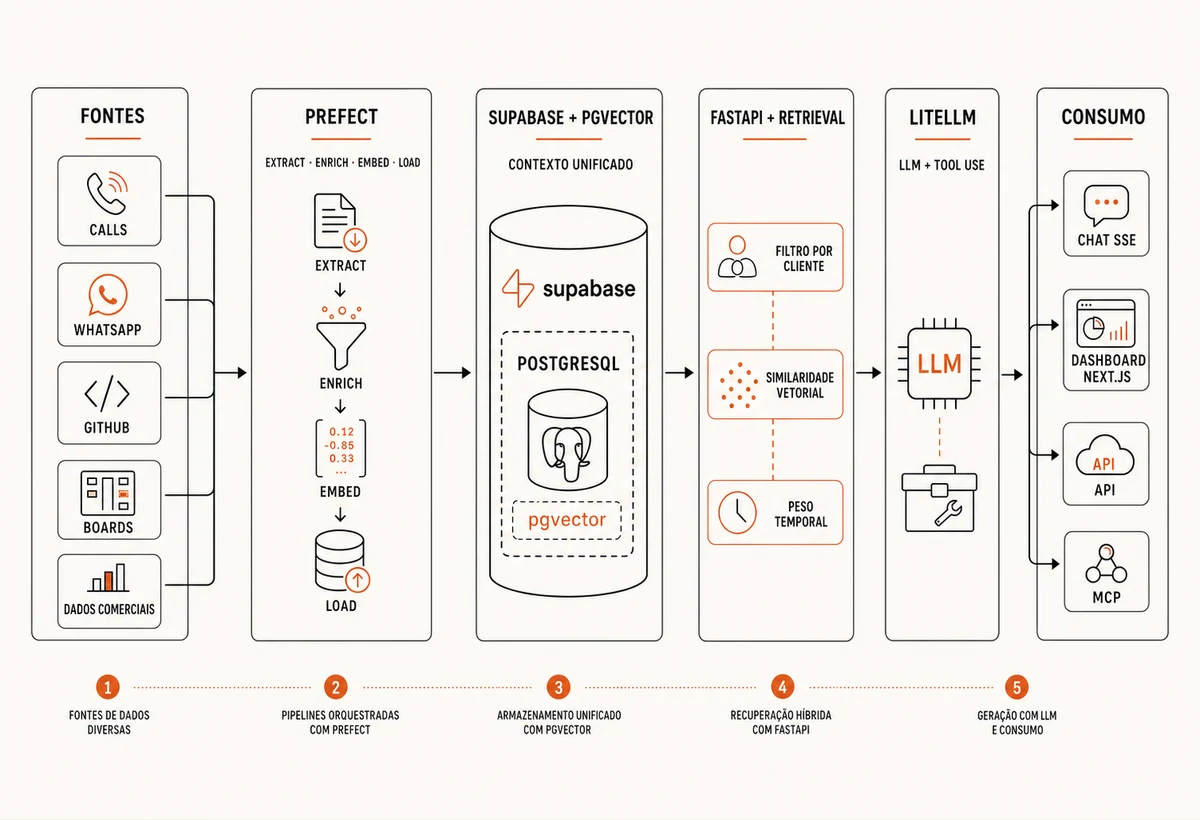
Flows Prefect executam extract → enrich → embed → load para calls, WhatsApp, boards e GitHub. Os embeddings são armazenados no Supabase com pgvector e vinculados a um identificador canônico de cliente. A API FastAPI combina filtro por cliente, similaridade vetorial e peso temporal; a resposta é transmitida em streaming pelo LLM via LiteLLM e também pode usar ferramentas. Frontend Next.js e MCP expõem o contexto para pessoas e outros agentes.
Decisões
Escolhas e trade-offs
RAG foi escolhido no lugar de fine-tuning para manter o conhecimento atualizável e auditável. O pgvector dentro do Supabase substitui a necessidade de GraphDB ou banco vetorial separado; pipelines explícitos mantêm a ingestão versionada; e o LiteLLM centraliza roteamento, fallback, cache e rastreamento de custo.
Desafios
Problemas encontrados
Reconciliar identidades entre bases distintas, garantir ingestões idempotentes, impedir prompt injection em conteúdo externo, aplicar autorização por cliente, medir regressões do RAG e equilibrar relevância, latência e custo em consultas com múltiplas fontes.
Resultados
O que foi alcançado
Calls, WhatsApp, boards, GitHub e dados comerciais passaram a compor uma camada de contexto pesquisável por chat, API e MCP. O sistema inclui reingestão controlada, streaming de respostas, rastreamento de custo e uma suíte versionada de avaliações do RAG.
Aprendizados
Aprendizados e evolução
Uma arquitetura RAG simples e observável pode superar soluções mais complexas quando identidade, qualidade dos dados, autorização e avaliação são tratadas como partes centrais do produto, e não como etapas posteriores.
Escrevi sobre isso