AI Agents · Retrieval · Observabilidade · Em desenvolvimento
Article Copilot: copiloto de escrita com auditoria de agentes
Ferramenta local que lê o contexto e as fontes de um projeto de escrita e devolve recomendações via 5 agentes LLM auditados, orquestrados por um DAG determinístico com cache de resultado e falha isolada por agente. Web read-only com progresso ao vivo por SSE e rastreio de sugestão aplicada por diff de texto.
Contexto
O cenário antes da solução
Escrever artigos técnicos com muitas fontes (PDFs, papers, notas) exige manter contexto e verificar o que cada fonte realmente diz. A ideia foi ter um copiloto local que conhece o material do projeto e explica cada recomendação.
Ingerir fontes heterogêneas, incluindo PDFs digitalizados, recuperar apenas o trecho relevante e registrar o que cada agente fez, custou e demorou, sem depender de serviço externo para o índice.
Meu papel
O que eu planejei, desenvolvi e implantei
Projeto pessoal: desenvolvimento ponta a ponta com TDD estrito.
Arquitetura
Como o sistema funciona
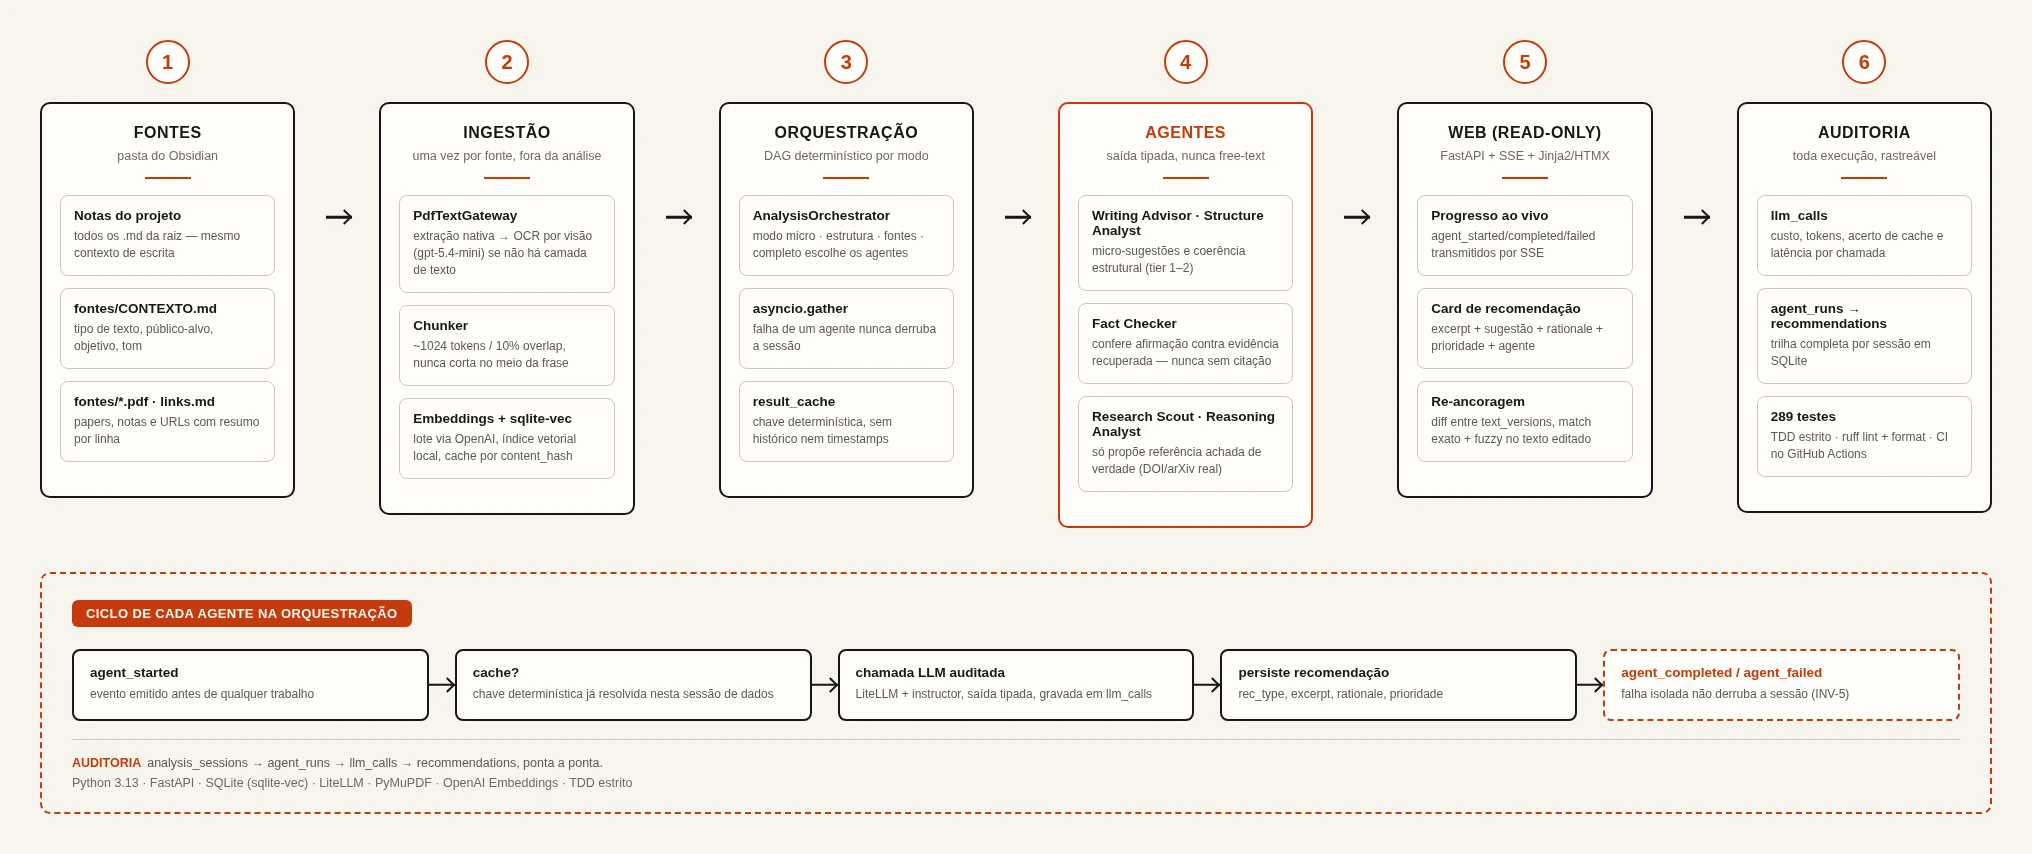
Pipeline de ingestão desacoplado (extração nativa com PyMuPDF, OCR por visão quando necessário, chunking e embeddings em lote indexados no sqlite-vec) alimenta um orquestrador que roda em paralelo os agentes do modo escolhido (micro, estrutura, fontes ou completo), com cache de resultado por chave determinística e falha isolada por agente. Os 5 agentes (revisão de escrita, estrutura, checagem de fatos, busca de referências e raciocínio) usam LiteLLM com saída tipada; toda chamada é auditada em SQLite (custo, tokens, acerto de cache, latência). Uma camada web em FastAPI, read-only sobre o texto, expõe o progresso ao vivo por SSE e infere o que já foi endereçado comparando o excerto original com a versão atual do texto.
Decisões
Escolhas e trade-offs
sqlite-vec no lugar de um banco vetorial separado, para manter a ferramenta local e sem infraestrutura; LiteLLM para trocar de modelo e rastrear custo; auditoria como tabela de primeira classe, não como log; orquestração como DAG determinístico em código em vez de um agente-orquestrador via LLM, para manter o fluxo previsível e barato de rodar.
Desafios
Problemas encontrados
Qualidade do OCR em PDFs digitalizados, custo de embeddings em lote, e reancorar uma recomendação depois que o texto foi editado fora da ferramenta. Esse último foi resolvido com match exato e fallback fuzzy, sem inventar uma posição quando a confiança é baixa.
Resultados
O que foi alcançado
289 testes automatizados escritos com TDD estrito; toda execução de agente e cada chamada de LLM rastreável por custo, cache e latência; interface web mostra o progresso da análise ao vivo e o histórico completo por projeto.
Aprendizados
Aprendizados e evolução
Auditar custo e latência por execução desde o primeiro commit muda as decisões de arquitetura e é o passo anterior à instrumentação com OpenTelemetry descrita no artigo de observabilidade. Separar o que é determinístico (orquestração, cache, diff) do que exige inferência (os agentes) manteve o sistema testável sem depender de LLM real em teste de unidade.